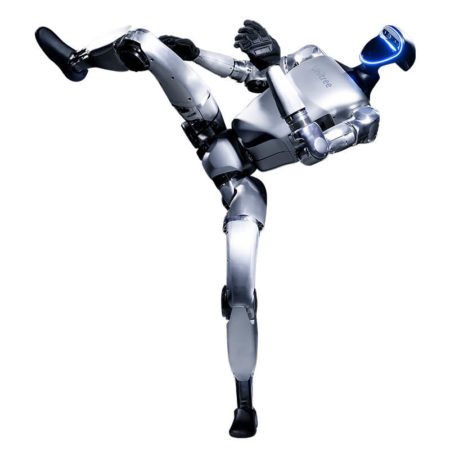
Человекоподобные роботы с лицом уже умеют двигать губами в такт речи и показывать мимику. Если такому роботу дать лицо реального человека и управлять им синтезированной речью, получится новый вид атаки предъявления: лицо, которое говорит и реагирует перед камерой, снятое как реальный объект без единого изменённого пикселя. Авторы называют это RoboFake и спрашивают, готовы ли современные защиты.
Они проверили три публичные модели обнаружения атак предъявления (PAD) и шесть публичных детекторов дипфейков на видео физического робота с синхронизацией губ, на синтезированном видео того же робота и на отрендеренных лицах робота. Пороги зафиксированы на человеческих данных (BPCER 5% на FaceForensics++), результаты сравниваются с реальными человеческими лицами, обработанными так же и повернутыми на тот же угол.
Небольшая мобильная PAD-модель обнаруживает каждый кадр физического робота (APCER 0%) и не зависит от сжатия, но её BPCER на обработанном видео людей растёт до 14%. Две модели, обученные на CelebA-Spoof, пропускают робота при прямой съёмке, и одна из них пропускает большинство кадров с экрана. Среди детекторов дипфейков три помечают почти каждый кадр робота, а два — менее 7%. Маскирование показывает, что реакция идёт от лица, но не отслеживает синтез, а JPEG-сжатие уводит большинство кадров робота ниже порога для некоторых детекторов.
Вывод: современные модели ловят сегодняшних роботов потому, что их лица не выглядят человеческими, а не потому, что распознают атаку. Авторы формулируют три проверяемые гипотезы о реалистичных интерактивных RoboFake.
Источник: arXiv:2610.14269